AI 토큰과 글자 수의 차이를 이해하고, 파이썬 tiktoken으로 영어 문장의 토큰 수를 직접 계산해보세요.
혹시 AI 모델 설명에서 "토큰"이라는 말을 보고 "그게 글자 수 얘기하는 건가?" 하고 대충 넘어간 적 있으세요?
결론부터 말하면 토큰은 글자 수와 비슷하지만 완전히 같지는 않아요.
지난 두 편에서 LLM이 뭔지, 전통적인 AI와 뭐가 다른지 살펴봤는데요, 오늘부터는 이번 주 내내 만들어볼 작은 프로젝트, "토큰 계산기"의 첫걸음을 시작해볼게요. AI가 우리 글을 어떻게 "읽는지" 그 최소 단위부터 짚고 넘어갈 거예요.
이 글에서 배울 내용은 토큰(Token)이 정확히 뭘 가리키는 단어인지
AI가 왜 글자 하나하나가 아니라 "토큰" 단위로 글을 처리하는지
파이썬 tiktoken 라이브러리로 텍스트의 토큰 수를 직접 세어보는 스크립트 작성을 해보겠습니다.
토큰(Token)이란 무엇인가
글자 수와 토큰 수를 구분하려면, 먼저 AI가 텍스트를 나누는 단위를 알아두면 좋아요.
토큰은 LLM이 텍스트를 처리하는 기본 단위로, 문장을 잘게 나눈 조각이라고 생각하면 돼요.
우리가 글자나 단어를 읽듯, 모델은 이 조각을 숫자 ID로 바꾼 입력을 처리해요.
비유하자면 문장이 완성된 레고 작품이고 토큰은 그 작품을 이루는 블록이에요.
블록의 크기와 모양이 다양하듯, 토큰도 단어 전체나 단어 일부, 공백이나 문장부호를 포함할 수 있어요. 따라서 토큰 하나가 항상 글자 하나나 단어 하나에 대응하는 것은 아니에요.
AI는 왜 토큰 단위로 읽을까
텍스트를 효율적으로 처리하려면, 얼마나 잘게 나눌지 정하는 기준이 필요해요.
알파벳 한 글자씩 나누면 익숙한 단어도 여러 단위가 되어 처리할 입력이 길어져요.
반대로 사전에 있는 단어 전체만 사용하면, 처음 보는 단어나 오타를 세밀하게 표현하기 어려워요.
이 글에서 사용할 BPE(Byte Pair Encoding)는 학습 데이터에서 자주 함께 나타나는 바이트나 조각을 합쳐 토큰 목록을 만드는 방식이에요.
쉽게 말해 자주 쓰는 조각은 크게 묶고, 다른 표현은 사용할 수 있는 작은 조각으로 나누는 방법이에요.
모든 LLM이 같은 토큰화 방식을 쓰는 것은 아니지만, OpenAI의 tiktoken은 BPE 기반이에요.
왜 토큰 수가 중요할까
긴 문서를 AI에 넣으려면 모델이 한 번에 처리할 수 있는 문맥의 한계를 알아야 해요.
이 범위를 컨텍스트 창이라고 부르며, 보통 토큰 수로 표시해요.
대화에서는 현재 문서뿐 아니라 이전 메시지와 지시문도 입력 공간을 차지하고, 답변을 생성할 공간도 고려해야 해요.
API, 즉 프로그램에서 모델을 호출하는 기능을 사용할 때는 입력·출력 토큰 수가 비용에도 영향을 줘요.
다만 ChatGPT 같은 서비스의 구독 요금과 API 사용 요금은 별개이므로, 구독료가 문장의 토큰 수만으로 결정된다고 이해하면 안 돼요.
이번 주에 만들 토큰 계산기는 선택한 인코딩으로 문자열의 토큰 수를 확인하는 도구이며, 실제 API 요청 전체의 사용량이나 요금을 계산하는 도구는 아니에요.
직접 만들어보는 실습 — tiktoken으로 토큰 수 세어보기
이제 이번 주 프로젝트의 첫 스크립트를 만들어볼게요.
OpenAI가 공개한 tiktoken 라이브러리에서 cl100k_base라는 인코딩을 선택해요.
인코딩은 텍스트를 어떤 토큰으로 나눌지 정하는 규칙이며, 여기서는 비교 기준을 고정하기 위해 이 값을 사용해요.
준비물: Python이 설치된 PC와 코드 편집기가 필요해요. 터미널에서 python --version이 실행되는지 먼저 확인하고, 설치와 스크립트 실행에 같은 python 명령을 사용하세요.
① 작업 폴더를 만들고 그 폴더에서 터미널을 열어요. 이미 터미널을 열었다면 cd "작업 폴더의 실제 경로"로 이동한 뒤 아래 명령을 실행해요. 처음 실행할 때는 인코딩 데이터를 내려받기 위한 인터넷 연결이 필요할 수 있어요.
python -m pip install tiktoken
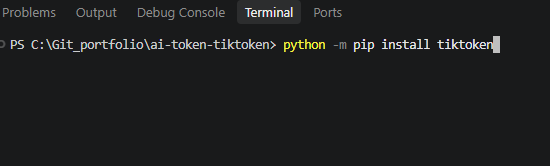
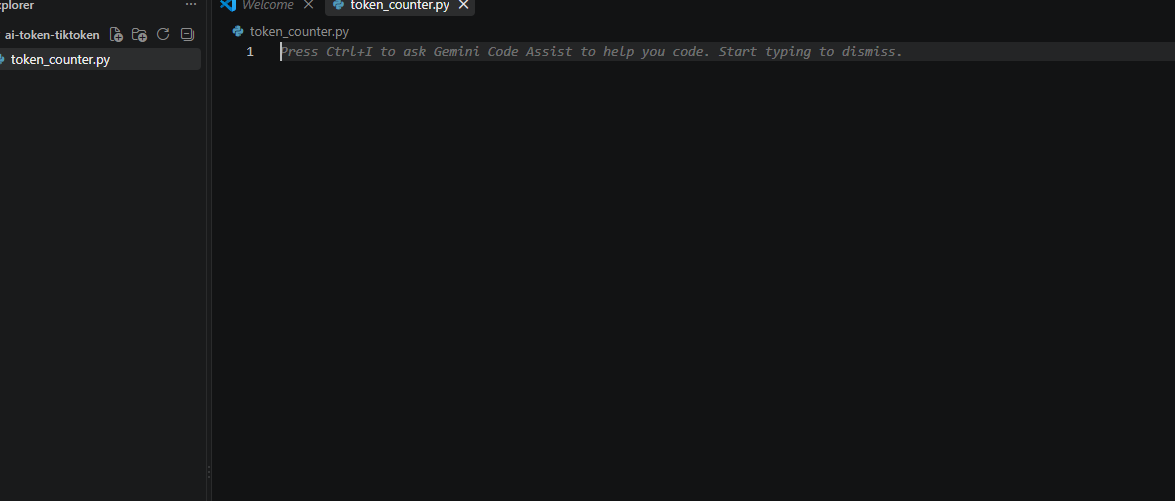
② 같은 작업 폴더에 token_counter.py 파일을 만들고 아래 코드를 저장해요. 파일 이름 끝에 .txt 가 붙지 않았는지도 확인하세요.
import argparse
import sys
import tiktoken
sys.stdout.reconfigure(encoding="utf-8")
def count_tokens(text: str, encoding_name: str = "cl100k_base"):
encoding = tiktoken.get_encoding(encoding_name)
token_ids = encoding.encode(text)
pieces = [encoding.decode([tid]) for tid in token_ids]
return len(token_ids), pieces
def main():
parser = argparse.ArgumentParser(description="Count tokens in a text string.")
parser.add_argument("text", help="Text to tokenize")
parser.add_argument("--encoding", default="cl100k_base")
args = parser.parse_args()
count, pieces = count_tokens(args.text, args.encoding)
print(f"Encoding: {args.encoding}")
print(f"Character count: {len(args.text)}")
print(f"Token count: {count}")
print(f"Token pieces: {pieces}")
if __name__ == "__main__":
main()
이 코드를 넣어줍니다.
③ 터미널에서 아래처럼 실행해요.
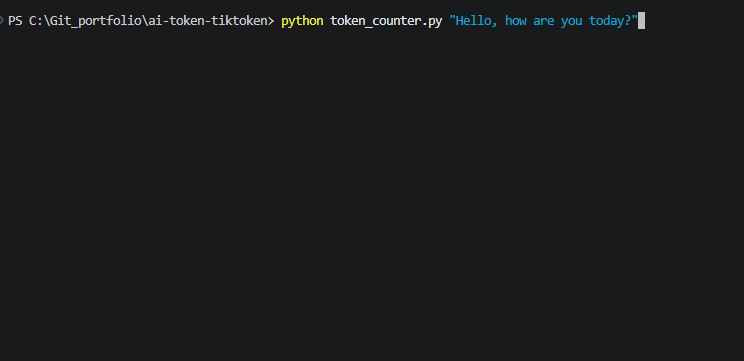
④ 실제로 실행하면 이런 결과가 나와요.
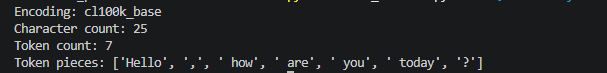
Encoding: cl100k_base
Character count: 25
Token count: 7
Token pieces: ['Hello', ',', ' how', ' are', ' you', ' today', '?']
⑤ 결과를 보면 25글자짜리 문장이 7개의 토큰으로 쪼개졌어요.
"Hello"는 통째로 하나의 토큰이 됐고, 쉼표(,)와 물음표(?)도 각각 독립된 토큰이 됐어요.
" how", " are", " you", " today"처럼 단어 앞에 공백이 붙은 채로 하나의 토큰이 되는 것도 눈여겨보시면 좋아요 — 공백이 다음 단어와 한 세트로 묶인다는 걸 확인할 수 있어요.
⑥ 설치 오류가 생겼을 때도 같은 스크립트를 다시 실행할 수 있도록 확인해요.
tiktoken이 설치되지 않은 Python 환경에서 실행하면 ModuleNotFoundError: No module named 'tiktoken' 오류가 발생해요.
설치를 생략했거나, 설치한 환경과 실행 환경이 다른 것이 대표적인 원인이에요.
같은 터미널에서 ①의 python -m pip install tiktoken을 실행한 뒤 ③의 명령을 다시 실행하고, 위 출력과 일치하는지 확인하세요.
한글 입력 시 주의: 이 코드에서 토큰 수를 세는 부분과 토큰 조각을 문자열로 표시하는 부분은 별개예요.
encoding.decode([tid])로 개별 토큰을 풀면 한글 한 글자의 바이트가 여러 토큰에 나뉘어 �로 표시될 수 있어요.
이는 표시 과정의 문제이며 토큰 개수가 틀렸다는 뜻은 아니에요. 개별 토큰의 원래 바이트를 확인하려면 encoding.decode_single_token_bytes(tid)를 사용해야 해요.
실행 확인 범위: 위 영어 문장은 실제 실행에서 25글자·7토큰과 동일한 조각 출력을 확인했어요. 한글의 글자 수 대비 토큰 수 비율은 문장과 인코딩에 따라 달라져요. 다음 편에서는 바이트 표시를 보완하고 영어와 한글 입력을 비교할 예정이에요.
- tiktoken은 어떤 모델의 토큰 수를 계산하나요?
-
tiktoken은 OpenAI 모델에 사용하는 토큰화 라이브러리예요.
-
이번 실습의 cl100k_base는 GPT-3.5-turbo와 GPT-4 등에 사용하는 인코딩이에요.
-
GPT-4o와 GPT-4o-mini는 o200k_base를 사용하므로 모든 GPT 모델의 기준이 같지는 않아요. 따라서 이번 결과는 “GPT 전체 기준”이 아니라 “cl100k_base기준”이라고 이해해주세요.
-
Claude나 Gemini의 토큰 수를 확인하려면 해당 제공자의 토큰 계산 기능을 사용해야 해요.
-
실제 API 요청에는 메시지 형식 등의 추가 요소가 있으므로, 이 스크립트의 문자열 토큰 수와 전체 사용량도 구분하세요.
-
- 토큰 수와 글자 수는 얼마나 차이 나나요?
- 이번 영어 문장 “Hello, how are you today?”는 공백과 문장부호를 포함해 25글자이고, 토큰은 7개예요.
- 이 문장에서는 토큰 하나당 약 3.6글자에 해당해요.
- 영어는 자주 쓰는 단어나 조각이 묶여 글자 수보다 토큰 수가 적어지는 경우가 많아요. 하지만 문장, 언어, 인코딩에 따라 결과가 달라지므로 이 비율을 다른 글에 그대로 적용하면 안 돼요.
- 한글도 글자 수와 토큰 수가 같다고 가정하지 말고, 사용할 인코딩으로 직접 확인하는 것이 좋아요.
- 다음 편에서 같은 계산기의 표시 방식을 보완해 영어와 한글의 차이를 비교해볼게요.
- ModuleNotFoundError가 나오면 어떻게 하나요?
- 이 오류는 스크립트를 실행한 Python 환경에서 tiktoken을 찾지 못했다는 뜻이에요.
- 같은 터미널에서 python -m pip install tiktoken을 실행해 설치하세요.
- 이후 python -m pip show tiktoken으로 해당 환경에 패키지가 설치되어 있는지 확인해요.
- 가상환경을 사용한다면 설치와 실행 때 같은 가상환경이 활성화되어 있어야 해요.
- 파일을 저장한 폴더로 이동한 뒤 python token_counter.py "Hello, how are you today?" 를 다시 실행하세요.
- Token count: 7 이 표시되면 이번 예제의 계산 결과와 일치해요.
오늘은 토큰이 정확히 뭔지, 그리고 왜 AI가 글자 대신 토큰 단위로 텍스트를 처리하는지 살펴봤어요.
토큰은 LLM이 텍스트를 처리하는 기본 단위이며, 글자나 단어와 항상 일치하지 않아요.
이번 실습은 BPE 기반의 cl100k_base를 사용하며, 다른 인코딩에서는 결과가 달라질 수 있어요.
토큰 수는 문맥 길이와 API 비용을 이해하는 데 유용하지만, 서비스 구독 요금과는 구분해야 해요.
'AI,도구' 카테고리의 다른 글
| [AI] 한글과 영어의 토큰 수 비교: 글자가 짧아도 토큰은 많을 수 있어요 (0) | 2026.09.28 |
|---|---|
| [AI] AI 모델 이름 읽는 법: 버전·성능 등급·서비스 요금제 구분하기 (0) | 2026.09.28 |
| [AI] 일상 속 AI와 생성형 AI의 차이: 스팸 필터·지도·번역기로 이해하기 (0) | 2026.09.18 |
| [AI] LLM이란? ChatGPT·Claude·Gemini의 원리와 차이 쉽게 이해하기 (0) | 2026.09.18 |
| [AI] LLM은 어떻게 답을 만들까? GPT·Claude·Gemini가 다르게 느껴지는 이유 (0) | 2026.09.17 |


